Przygotowując się do wejścia na giełdę, czołowe firmy od tworzenia oprogramowania korzystającego z dużych modeli językowych (LLM, large language models) wskazują ryzyko zagłady ludzkości jako czynnik, który inwestorzy muszą wziąć pod uwagę przed zakupieniem ich akcji. Zmiany klimatu idą tylko naprzód — ryzyko zdarzeń ekstremalnych rośnie z każdym rokiem. Cyberataki na zachodnią infrastrukturę, pewnie ze strony Chin, Rosji albo i USA, kto wie, co tam robią pojebusy od prezydenta-gwałciciela Trumpa, ciągle trwają. Przedwczoraj dostaliśmy informację o sporym ataku na polskie Autopay — firma twierdzi, że wygląda na to, jakby sprawcy ataku korzystali z AI. Tak samo do przedwczoraj trwał prawie dwudniowy meltdown systemów Microsoftu. Z kolei amerykańska agencja nadzorująca lotnictwo wstrzymała starty wszystkich samolotów na kilka godzin w nocy z piątku na sobotę polskiego czasu, choć przyczyny są nadal niejasne.
Ta katastroficzna preambuła to tylko wycinek zdarzeń lub wizji, które staram się obserwować z emocjonalnego dystansu, ale które jednak czasami sprawiają, że się niepokoję.
Nie jestem i raczej nie zostanę survivalowcem, ale przyznaję: od jakiegoś czasu, trochę od niechcenia, myślę, jak się przygotować do chwilowych przerw w cywilizacji.
(Nie zastanawiam się nad scenariuszami trwałego upadku cywilizacji, bo tu w moim szczerym przekonaniu najlepszym wyjściem jest eutanazja, a najlepszą poradą jest ta od znajomego lekarza o domowych mieszankach tableteczek, które mogą pomóc w tak przykrych sytuacjach.)
Żyjemy w świecie, który spełnił jedno z marzeń oświeceniowych encyklopedystów: większość ludzkiej wiedzy została agregowana i wydestylowana do wspaniałej, wszechogarniającej encyklopedii. Byłoby smutno stracić do niej dostęp z tak błahych powodów jak umiarkowanie intensywna globalna wojna nuklearna czy na przykład pandemia ptasiej grypy wymieszana z behawioralnym wirusem prawicowego, antyszczepionkowego kontrarianizmu.
W tej notce opiszę w skrócie, jak stworzyłem sobie kopię Wikipedii, która będzie mi działać w domu, nawet gdyby nie było już żadnego internetu.
Kiwix
Podstawą lokalnej Wikipedii jest projekt Kiwix, którego celem jest udostępnienie zasobów internetu, takich jak Wikipedia czy książki z Project Gutenberg, tam, gdzie internet nie sięga.
W bibliotece projektu można znaleźć dużą kolekcję gotowych archiwów w formacie ZIM. Po wybraniu języka „English” i kategorii „Wikipedia” dostajemy między innymi trzy wersje Wikipedii:
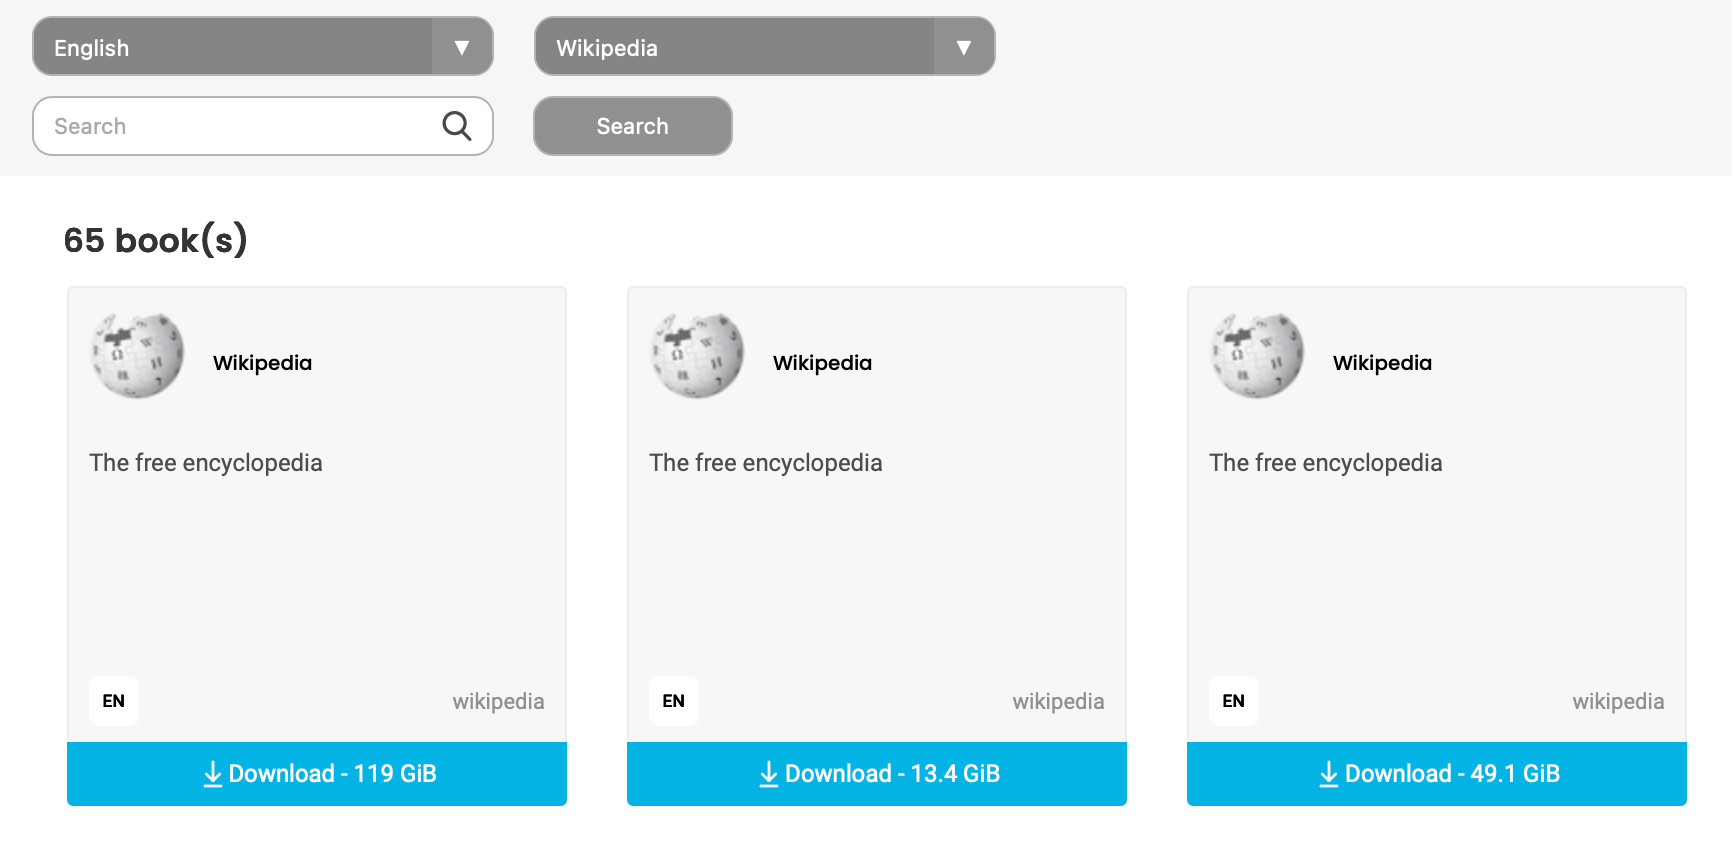
Największa zawiera artykuły i obrazki, średnia to artykuły bez obrazków, a najmniejsza to wstępy do artykułów i infoboksy, bez obrazków.
Jeśli z jakiegoś powodu nie chcecie mieć całej Wikipedii, w bibliotece projektu znajdują się także mniejsze „fragmenty” Wikipedii, wyselekcjonowane wedle różnych tematów. Ja sam poszedłem po wersję max angielskiej Wikipedii, zajmującą około 128 GB. Oczywiście możecie pobrać wersje w innych językach też.
Gdy klikniecie na „Download”, pojawią się opcje:
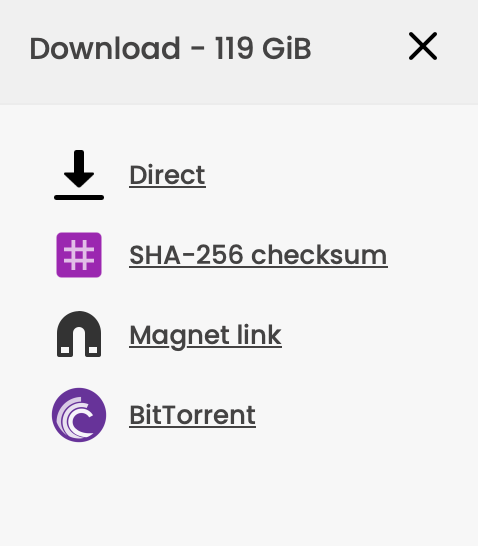
„Direct” bezpośrednio pobiera dane archiwum na wasz komputer, używając standardowego pobierania przez przeglądarkę. Ja sięgnąłem po pobieranie wykorzystujące protokół torrent — wtedy przeglądarka pobiera mały plik torrent, który możecie zachować i otworzyć w dowolnym momencie w kliencie torrent, gdy zechcecie pobrać dane. Ja wykorzystałem tę opcję, bo postanowiłem umieścić swoją kopię Wikipedii na dysku NAS.
Jeszcze jedna uwaga: strona zalinkowana wyżej — „biblioteka” — to interaktywna kolekcja. Projekt Kiwix udostępnia też indeksy grupujące różne wersje Wikipedii pod względem języka, wersji i „edycji”, czyli czasu, gdy dane archiwum zostało przygotowane:
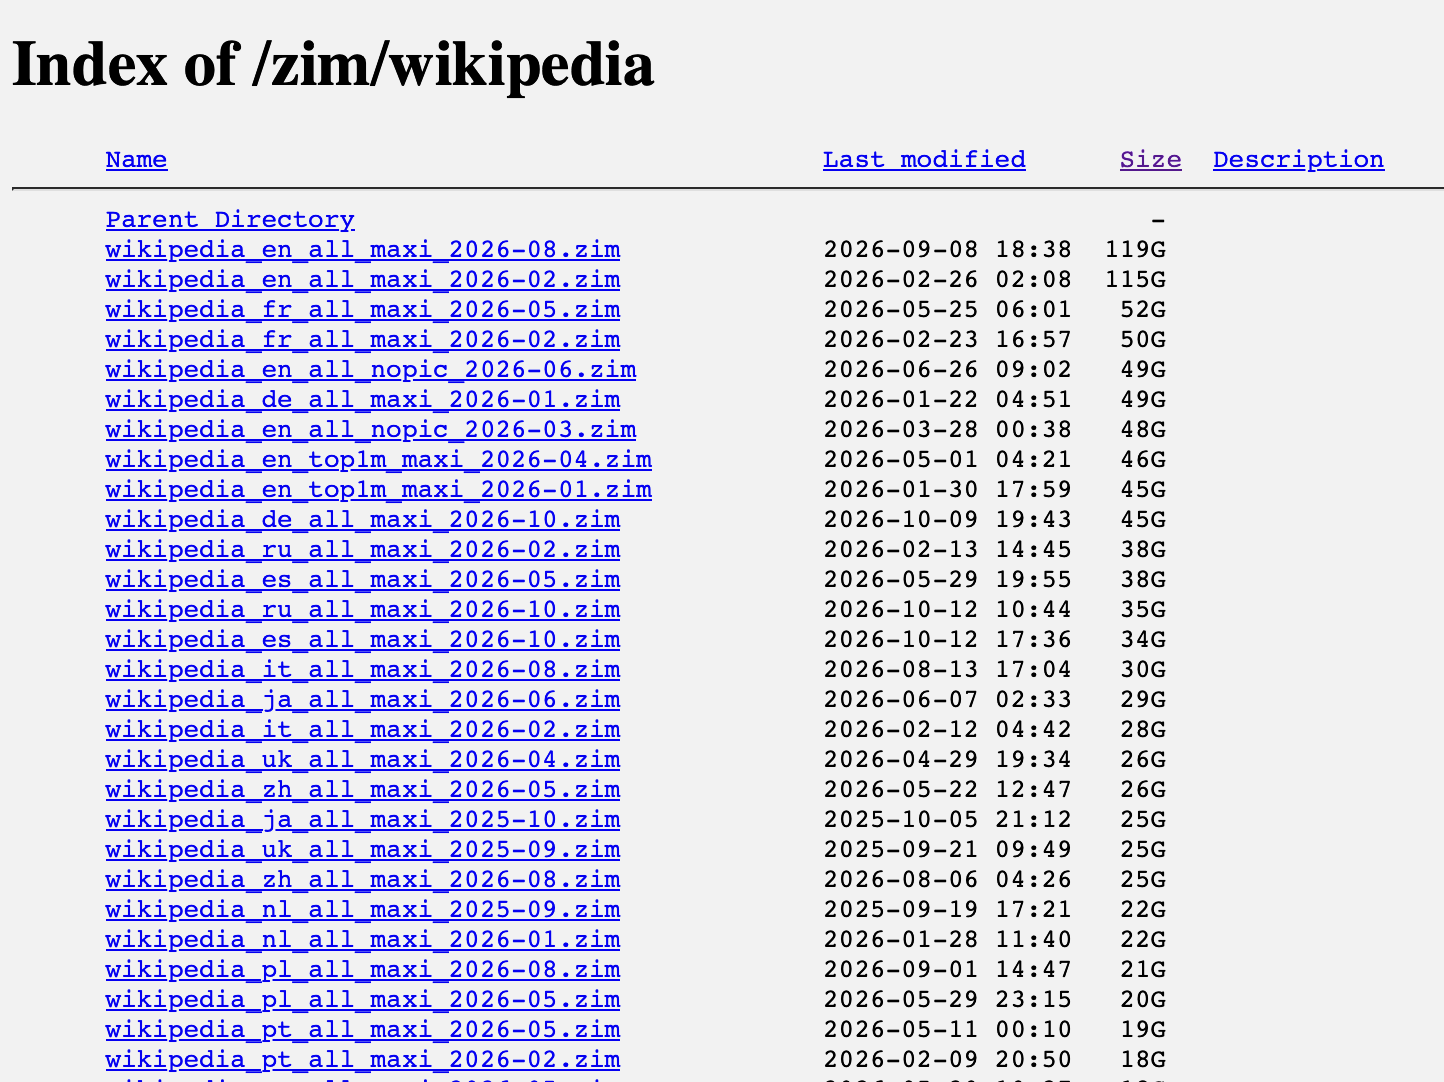
Może być wygodne, jeśli na przykład chcecie szybko sprawdzić, czy macie najnowszą dostępną wersję u siebie.
Mój setup
NAS-y to relatywnie proste komputerki, których główną funkcją jest zapewnić i udostępnić możliwie duże zasoby pamięci masowej innym urządzeniom w sieci (zazwyczaj sieci lokalnej). Znanym producentem NAS-ów jest np. Synology.
Gdybym miał zużywać 120 GB dysku w moim MacBooku na kopię Wikipedii, do której, w założeniu, zaglądałbym tylko w scenariuszu Upadku, pewnie by mi było żal, ale 120 GB nie robi takiego wrażenia, gdy składowane jest na mającym kilkadziesiąt terabajtów pojemności NAS-ie.
ChatGPT dość szybko opracował mi instrukcję krok po kroku uruchomienia lokalnej Wikipedii na NAS-ie Synology:
- Najpierw z Centrum pakietów (biblioteki programów, z której pobiera się aplikacje na NAS) zainstalowałem Container Manager służący zarządzaniu czymś, co nazywa się kontenerami Dockera.
- Przeprowadziłem standardową konfigurację Container Managera, po zakończeniu której na moim NAS-ie pojawił się folder współdzielony „docker”.
- Wewnątrz folderu „docker” utworzyłem podfolder „kiwix”, a w nim „data”.
- Otworzyłem plik torrent, o którym wspominałem w poprzedniej sekcji, w Download Station (klient torrent Synology) na NAS-ie. Jako miejsce pobrania wskazałem folder „data”. Ściąganie 128 GB Wikipedii trwało około godziny — czas zależy oczywiście mocno od szybkości waszego łącza.
- Rozpocząłem konfigurację serwera Kiwix. Otworzyłem Container Managera i wybrałem opcję utworzenia nowego projektu ze źródłem wskazanym jako „Prześlij plik docker-compose.yml”. Wklepałem tam konfigurację zasugerowaną przez ChatGPT i sfinalizowałem kreację. Container Manager chwilę mielił, konfigurując wszystko, i voilà, gotowe!
Zasugerowana przez ChatGPT konfiguracja do wklejenia w tworzony plik YML to:
services:
  kiwix:
    image: ghcr.io/kiwix/kiwix-serve:latest
    container_name: kiwix
    restart: unless-stopped
    ports:
      - "8088:8080"
    volumes:
      - "./data:/data:ro"
    command: ["*.zim"]
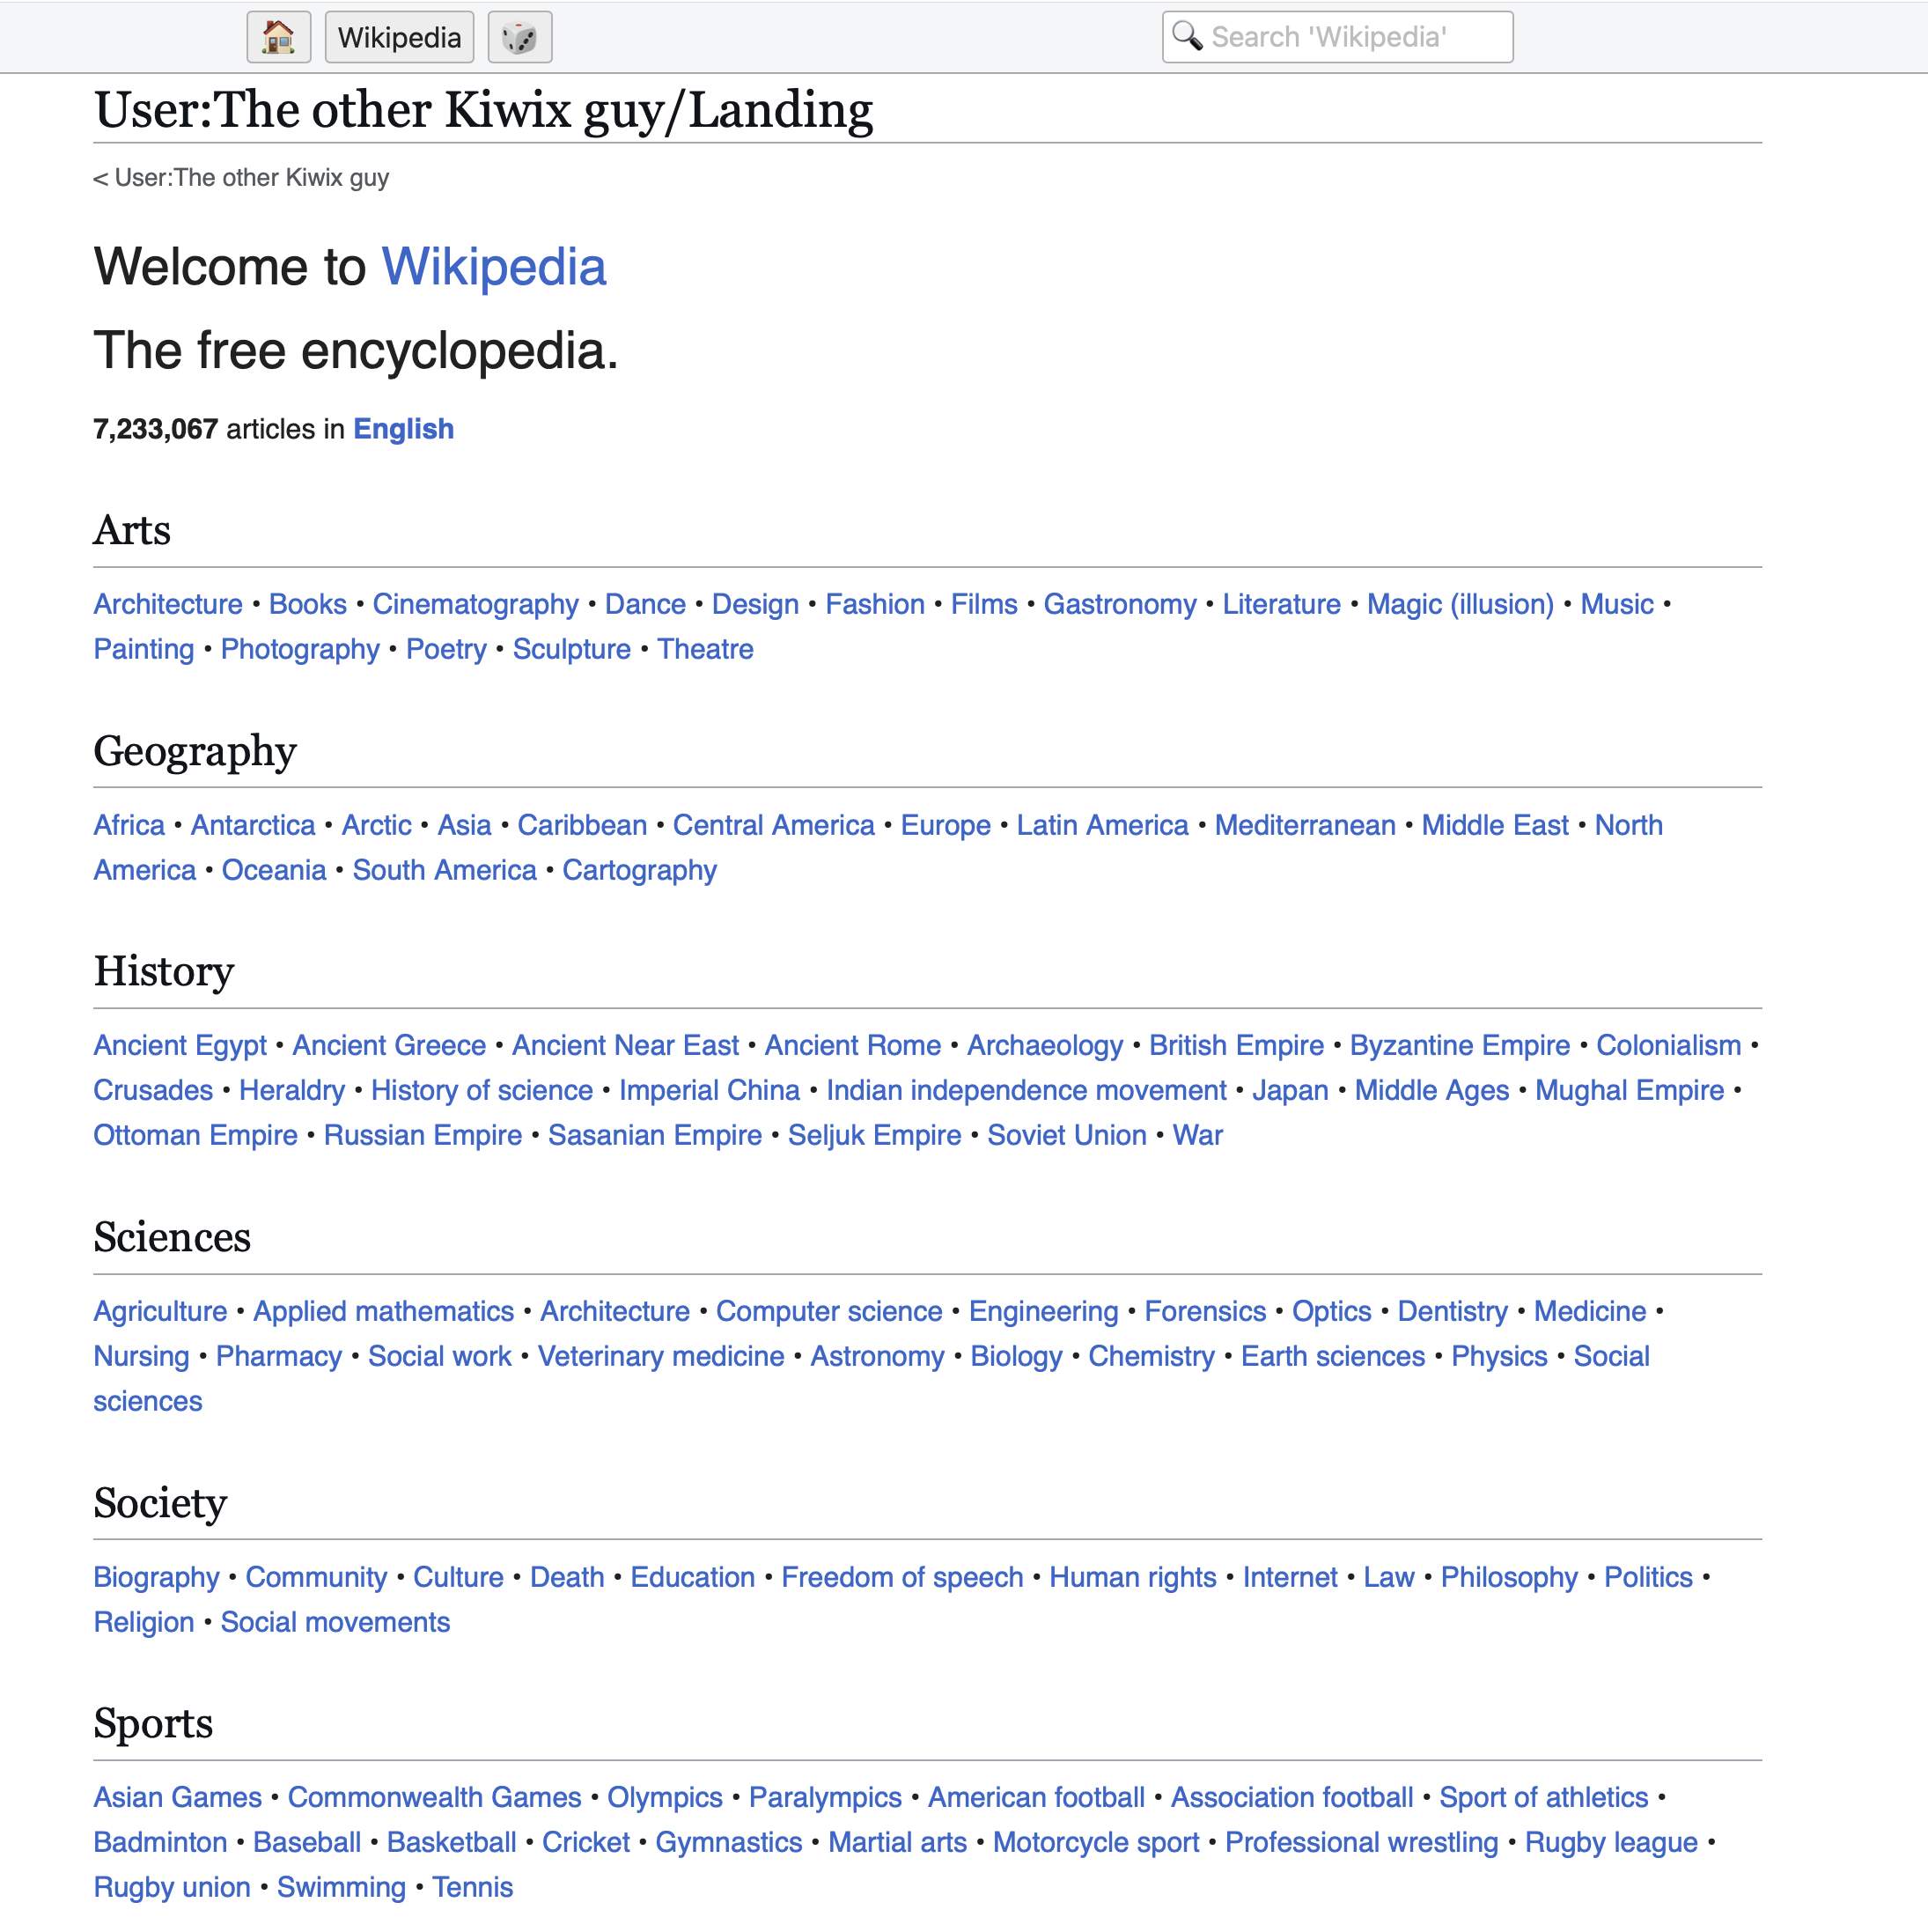
Po otwarciu lokalnego adresu mojego NAS-a na porcie 8088 widzę jakby kopię „biblioteki” projektu Kiwix, którą linkowałem wcześniej. Z tym że ta działa na danych zapisanych na moim lokalnym serwerze oraz pokazuje tylko te „książki”, które pobrałem, w moim przypadku angielskojęzyczną Wikipedię:
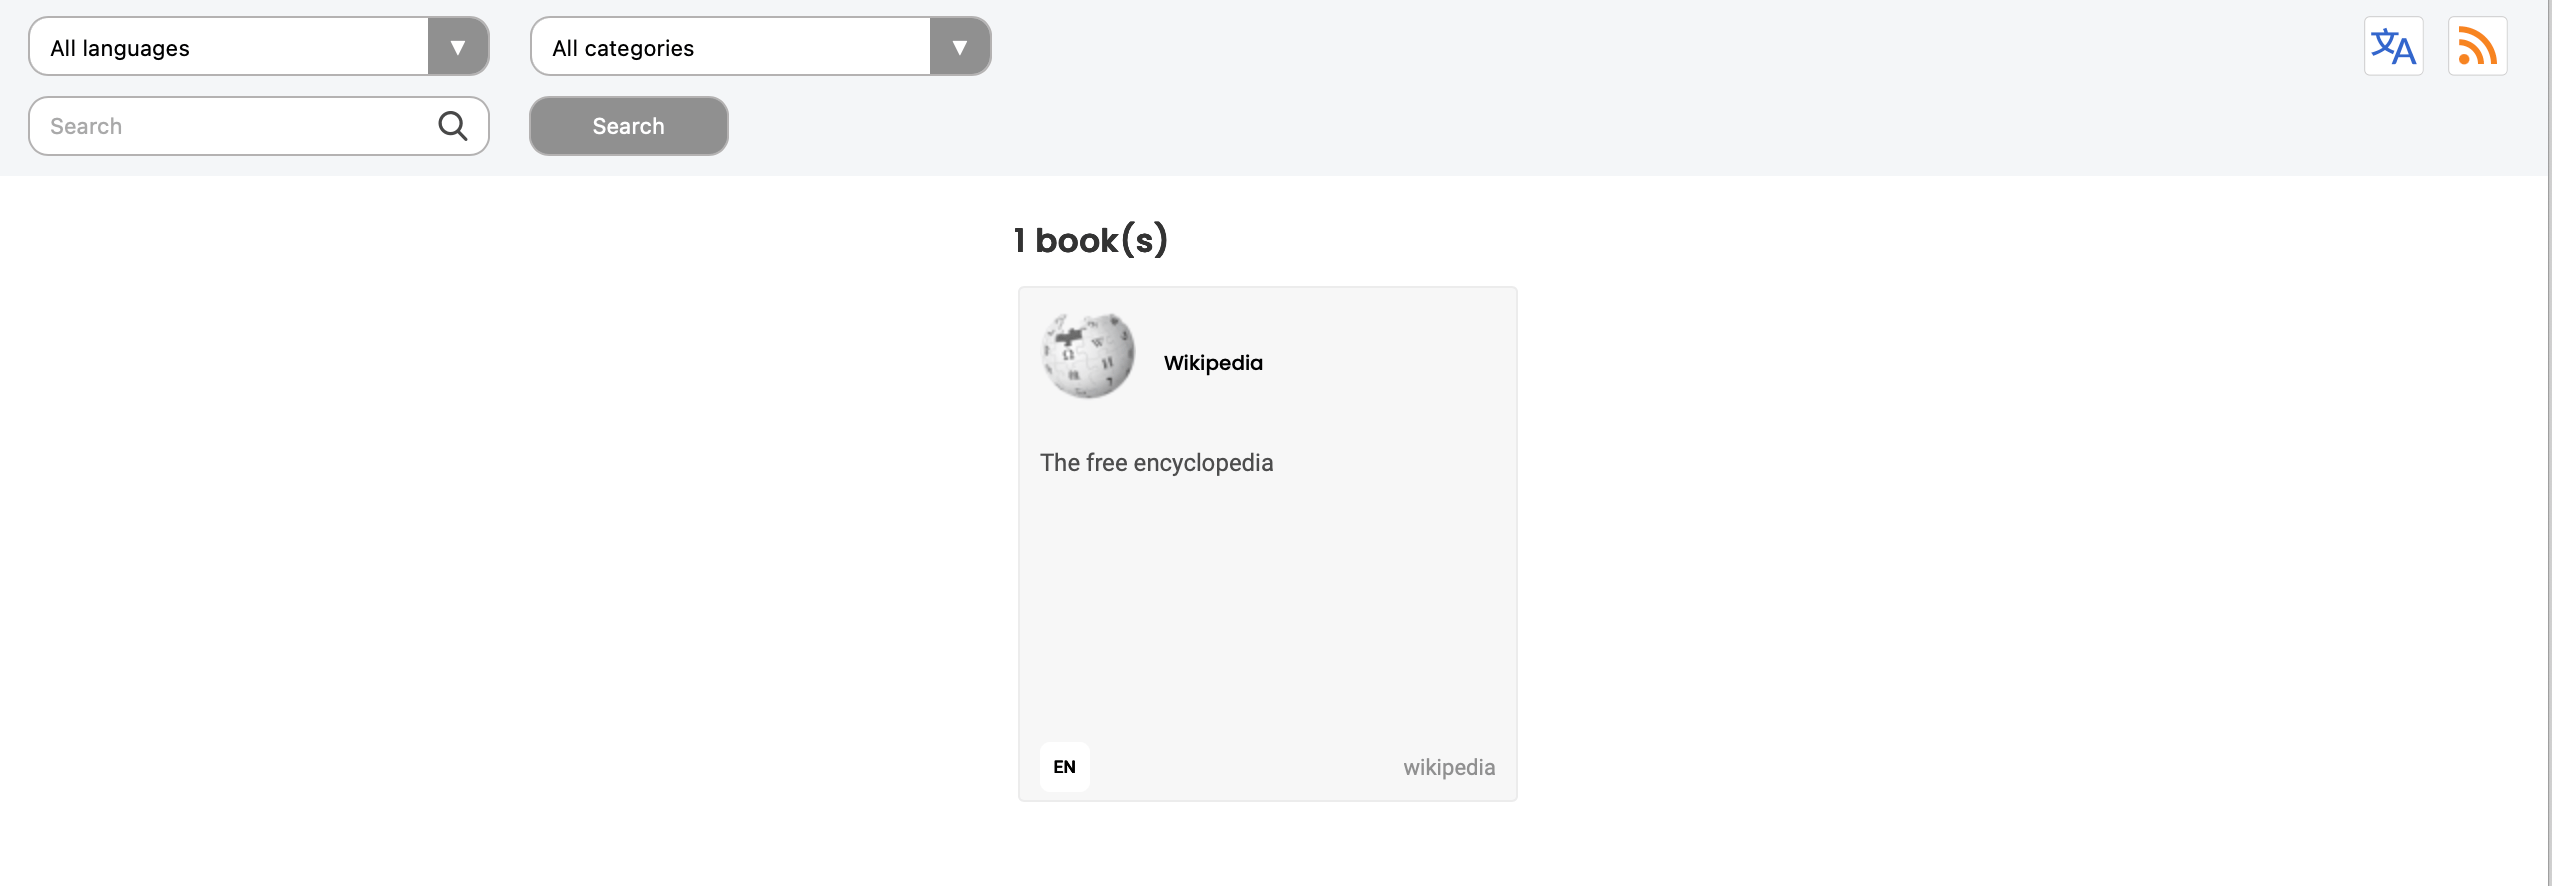
Jeśli teraz kliknę na taką Wikipedię, mogę przeglądać jej zawartość i wyszukiwać za pomocą wyszukiwarki:
Artykuły po otwarciu wyglądają bardzo podobnie do wersji online:
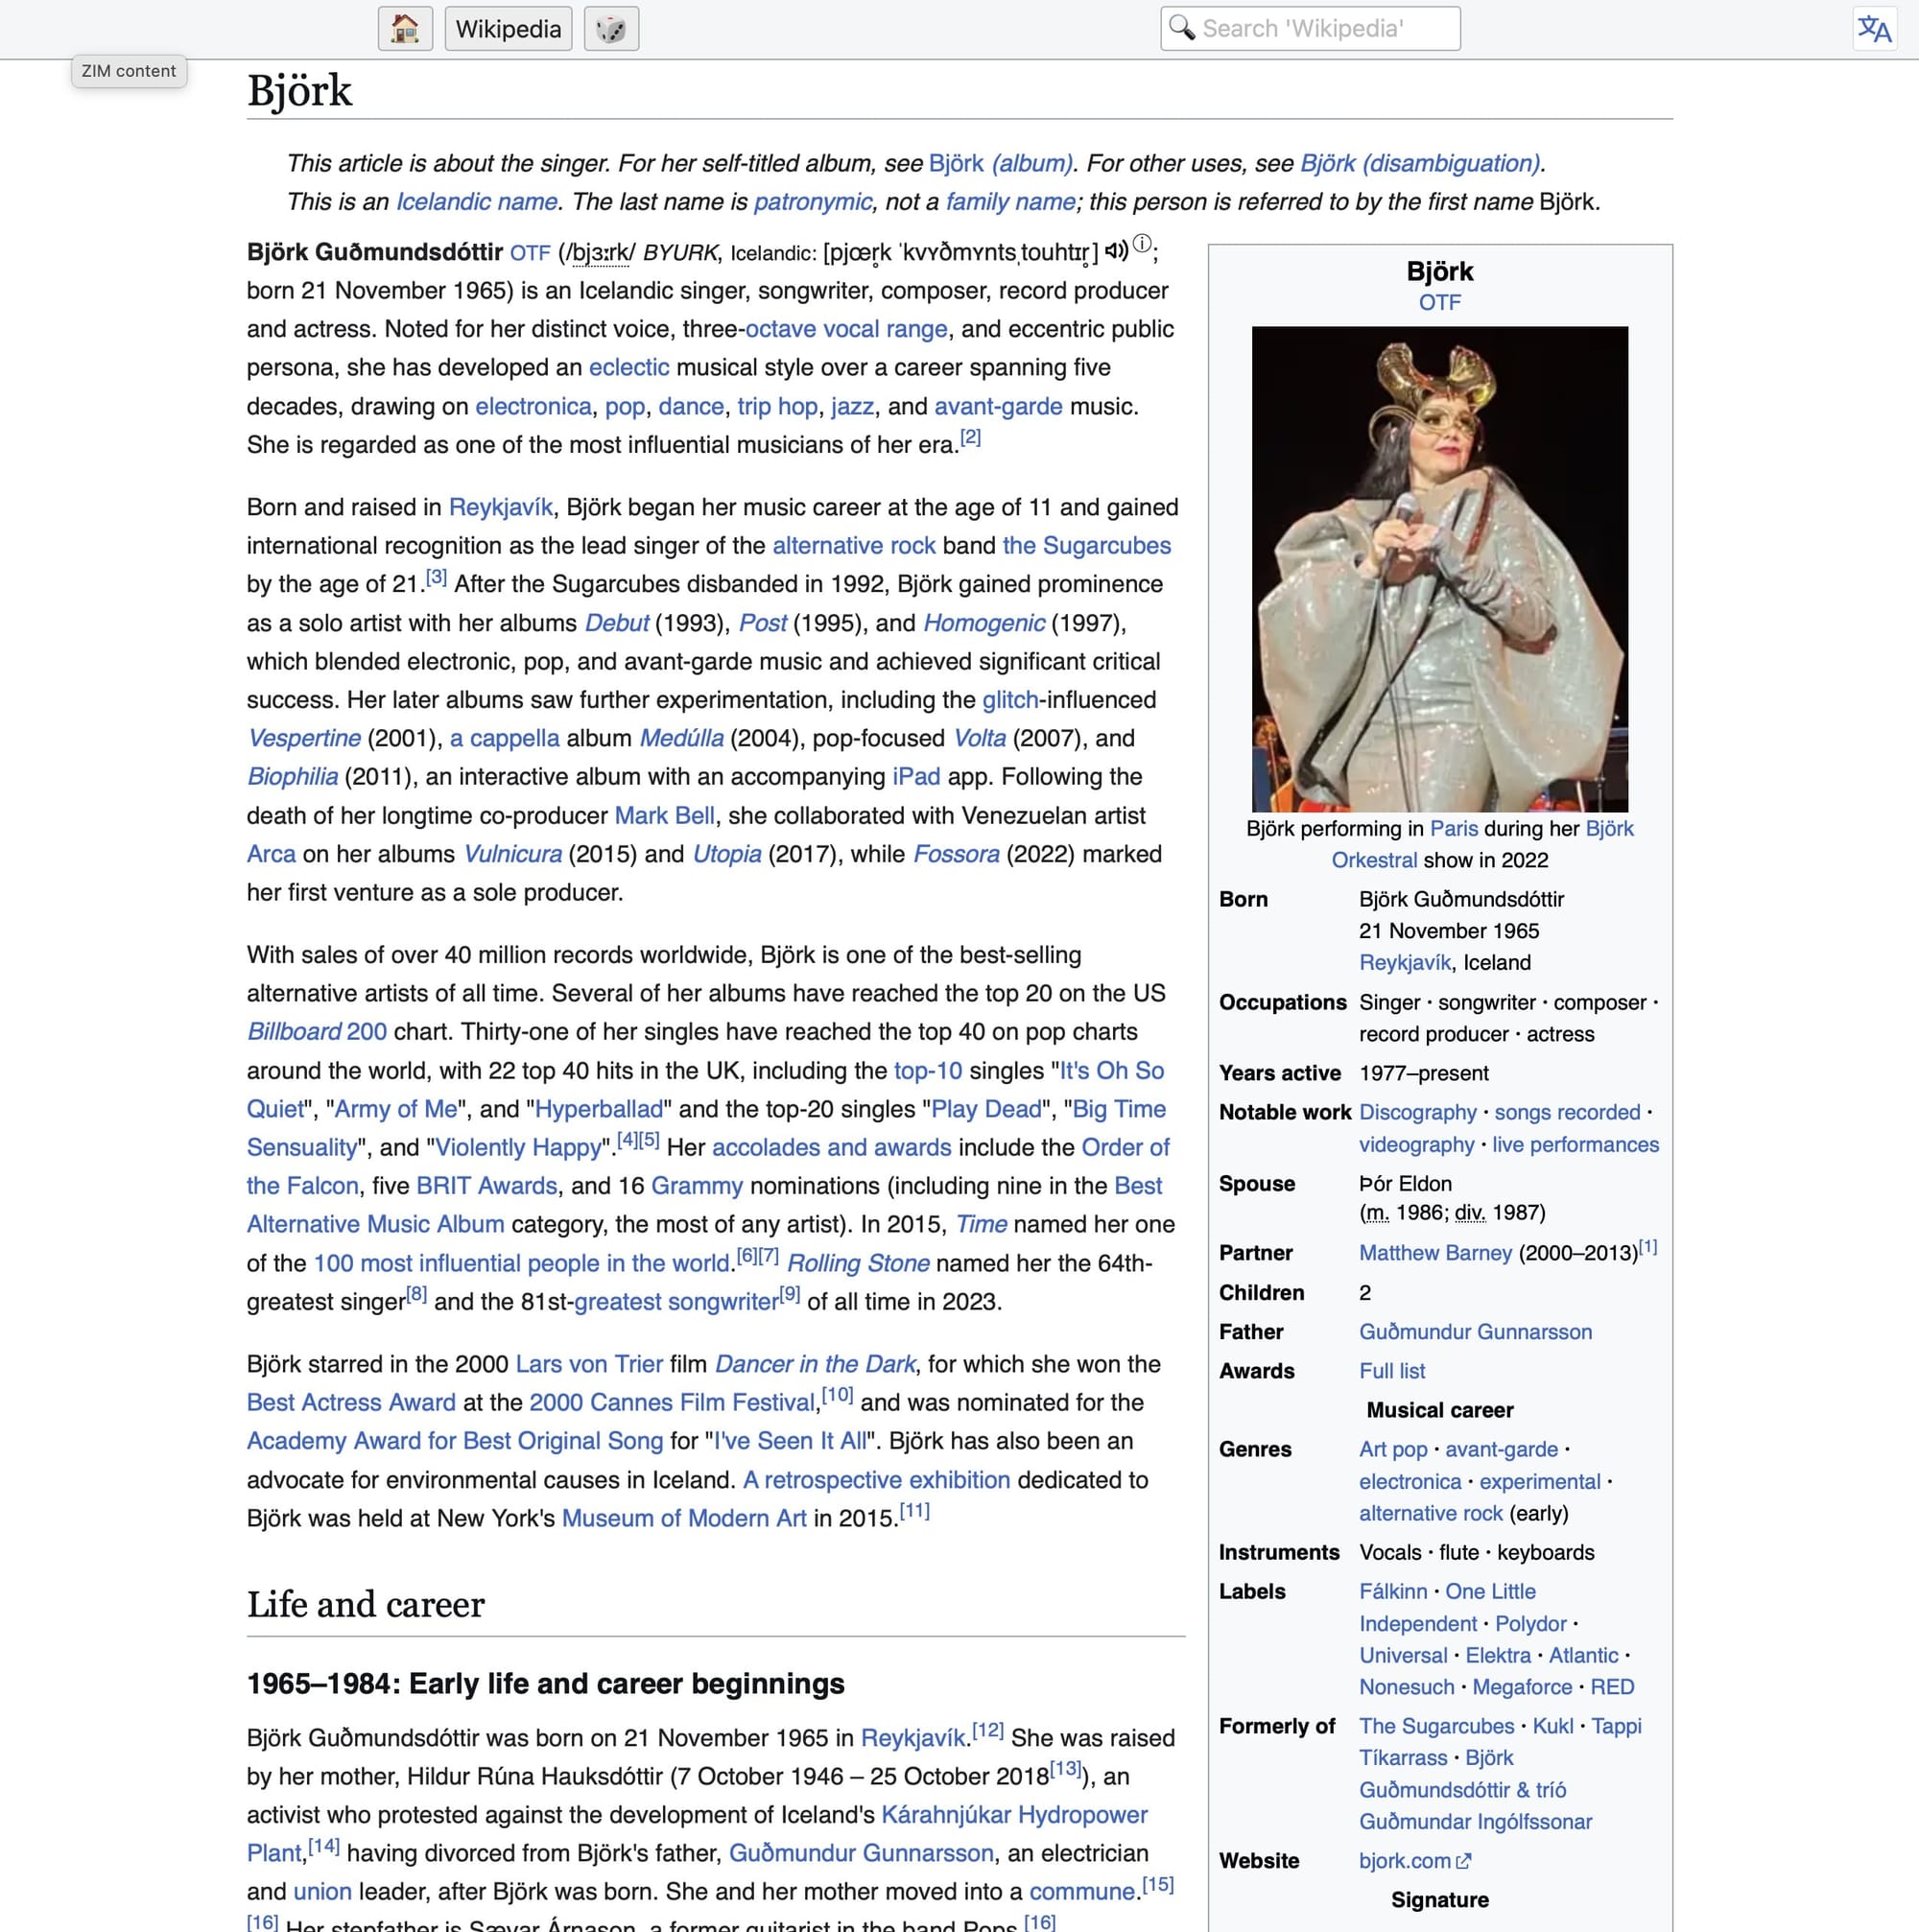
Główne różnice:
- brak dyskusji i historii edycji;
- grafiki są skompresowane i zredukowane do wielkości, w jakiej są osadzone w artykule — nie można ich kliknąć, by wyświetlić pełny rozmiar.
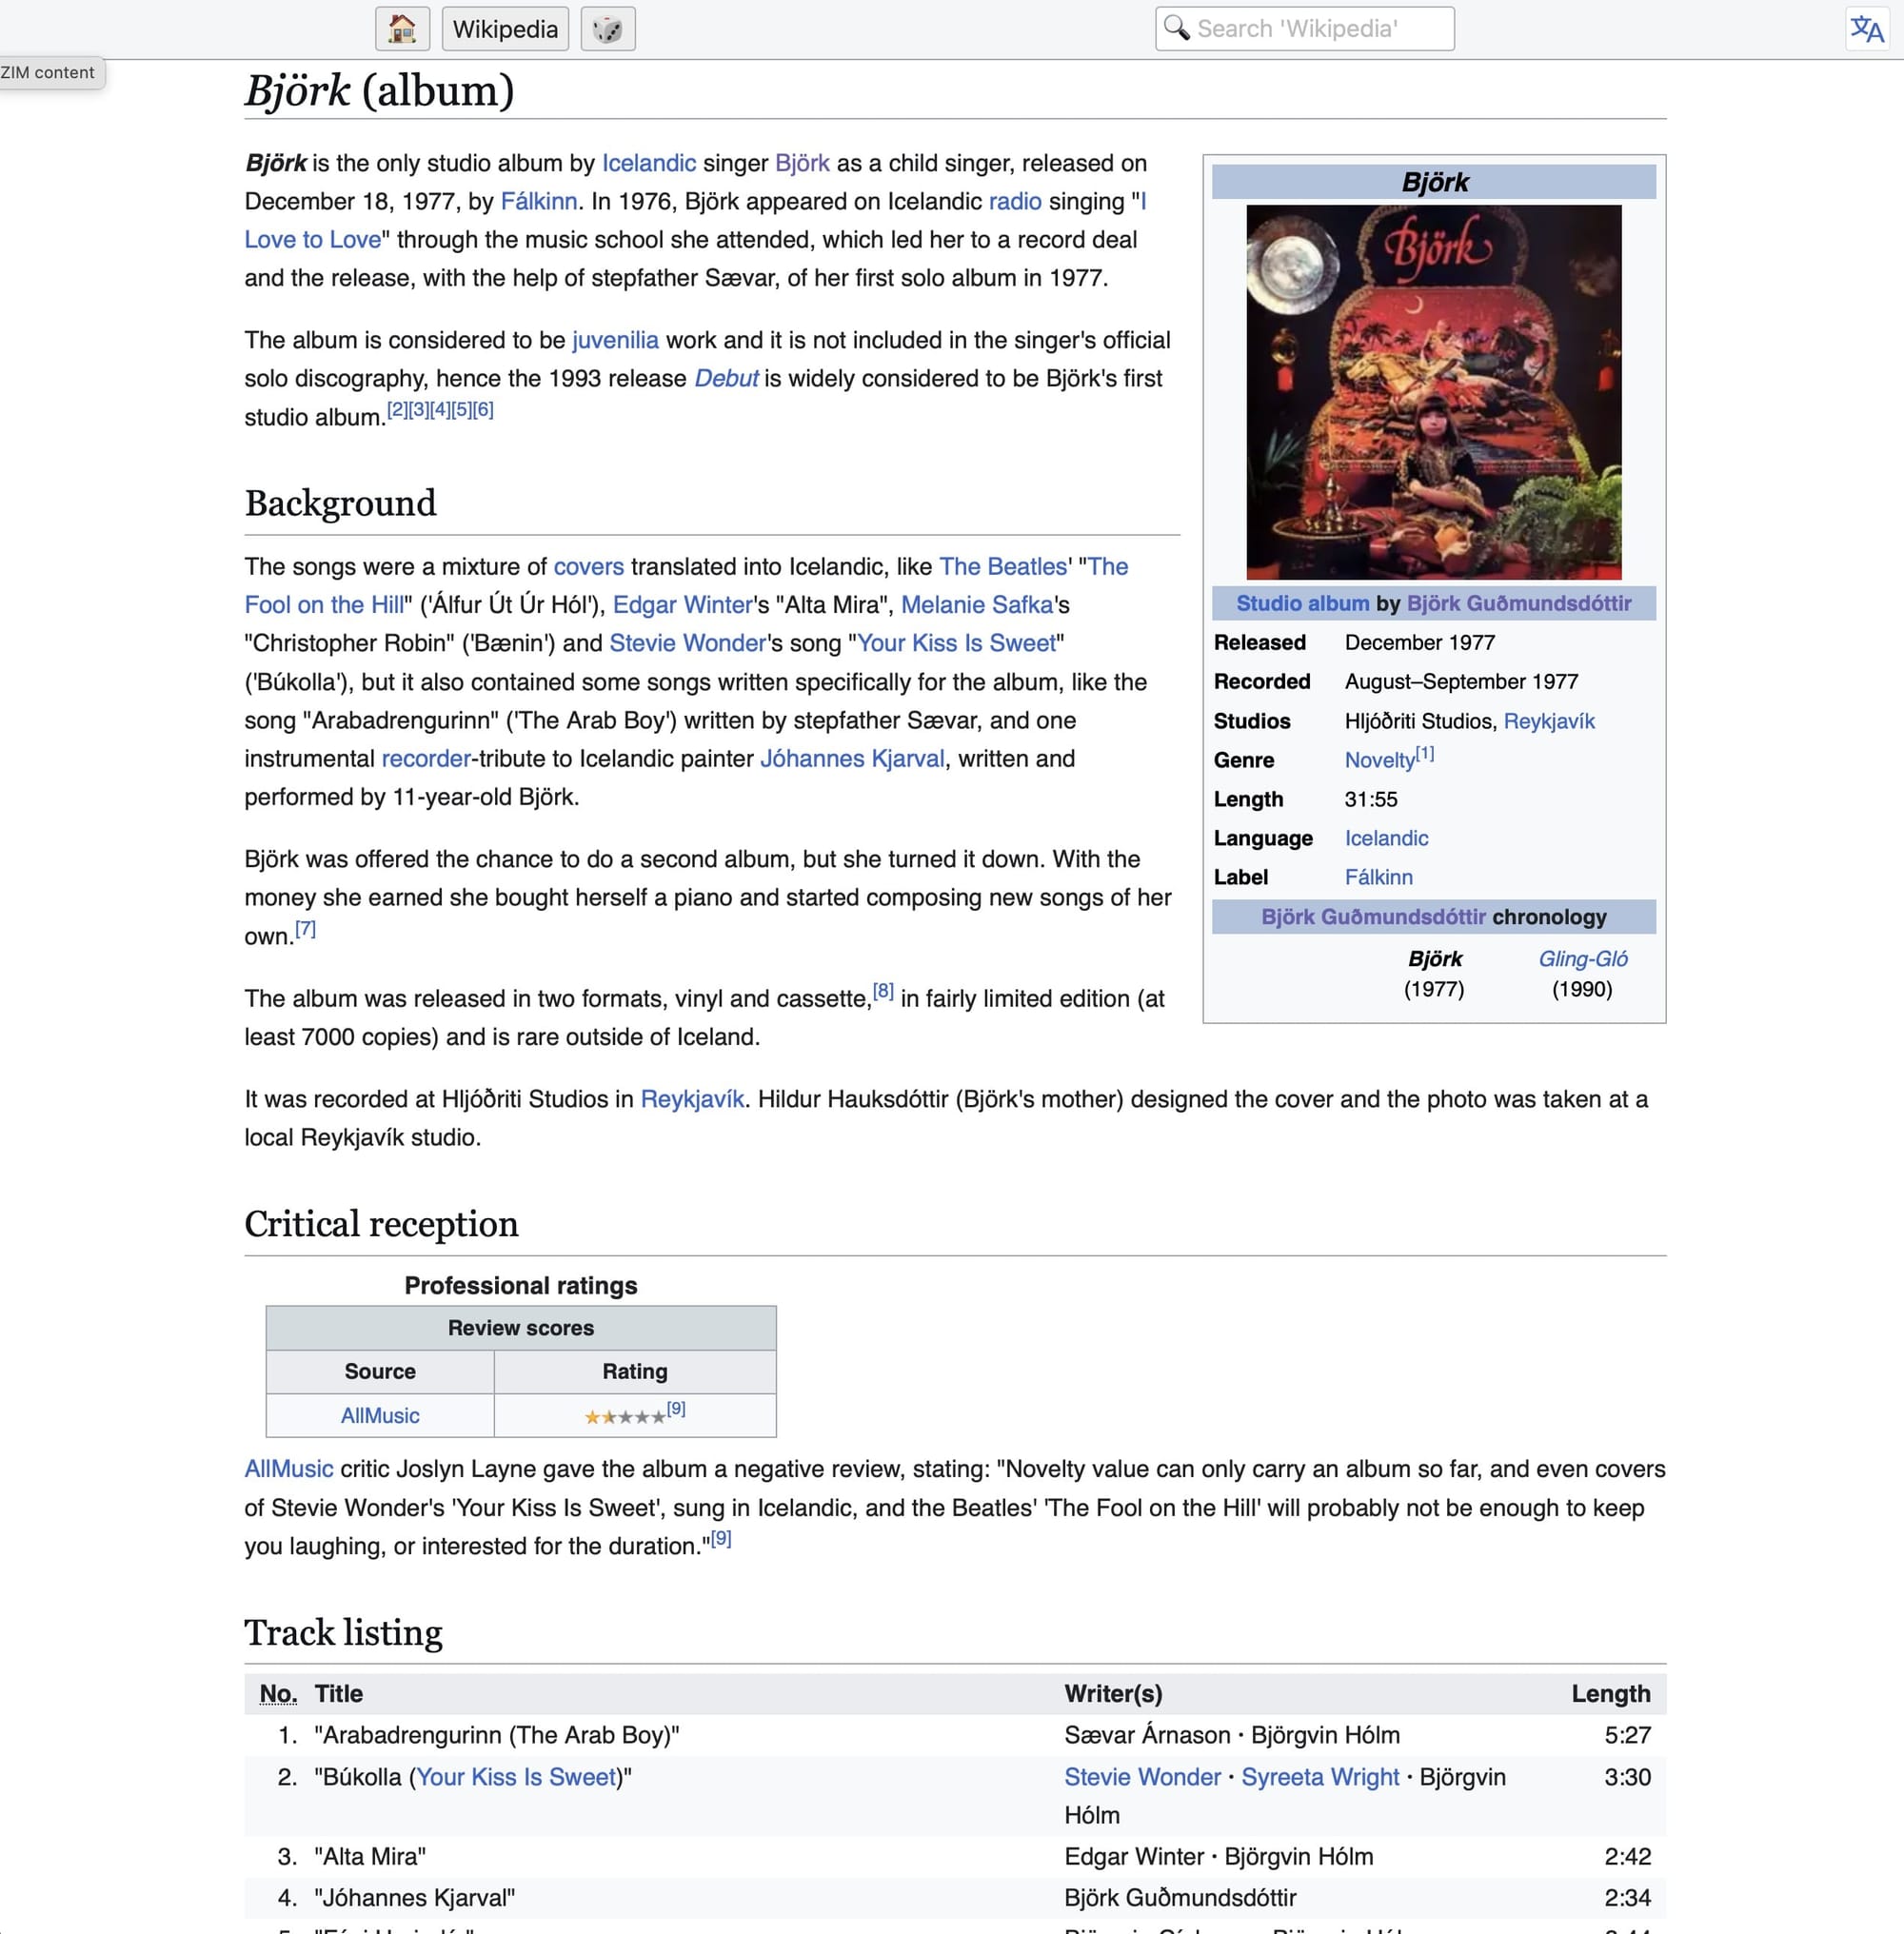
Wszystkie linki w obrębie Wikipedii działają. Jeśli kliknę na „Björk (album)”, to przeniesie mnie do strony z opisem albumu:
Konfiguracja na własnym komputerze, jeśli nie macie NAS-a, może być praktycznie taka sama: oczywiście musicie użyć stosownego managera kontenerów Dockera czy klienta torrent, które są dostępne w waszym systemie operacyjnym. Główna zaleta NAS-a, jeśli takowy posiadacie, poza oszczędzaniem miejsca na dysku komputera osobistego, to to, że zwykle NAS jest cały czas online, a komputery czy laptopy większość ludzi okresowo wyłącza lub usypia.
Polecam też stronę projektu Kiwix: mają tam rozwiązania, jeśli np. chcecie Wikipedię lub inne zasoby mieć na swoim telefonie, tablecie czy komputerze, bez tworzenia serwerów: działa to wtedy tak, że korzystacie ze specjalnego czytnika archiwów ZIM, który wczytuje plik takiego archiwum bezpośrednio, bez udostępniania innym urządzeniom. Ma to sens, jeśli, na przykład, jedynym waszym komputerem jest telefon (choć oczywiście czynnikiem limitującym jest pamięć masowa telefonu).
Być może robienie takich rzeczy to przesadne panikarstwo. A być może przerwa w cywilizacji da nam okazję do jakże potrzebnego cyfrowego detoksu: każdy skorzysta, zamieniając przewijanie odmóżdżających wideo na czytanie Wikipedii!
